tekoäly

How I built my personal AI assistant office, working in media (pros and cons)

Testing the Gemini image generation API via my assistant. Skip to the end to see the result (two monkeys instead of one, haha).

An honest TLDR: This is an ongoing project that will probably never end. But an extremely interesting one. Is it useful? Definitely? Is it perfect? No.

So, as you might know, I’m not a programmer at all but I have had quite a clear idea of how I would like this thing to work. I built this by vibe-coding in Claude Code and made gradual changes along the way. One inspiration has been my friend Jaakko’s own experiment that you can read about here (opens to another tab).

The idea

Instead of one chatbot that tries to do everything, I made a small office. One lead assistant (orchestrator agent) understands what I want and decides who does the work. Specialist helpers do most the actual jobs. Basically I started with prompting and planning first with my Claude, listing my wishes and finding out what’s realistic. I connected my assistant to Codex as well for a while but disconnected it after testing fo the time being.

The structure
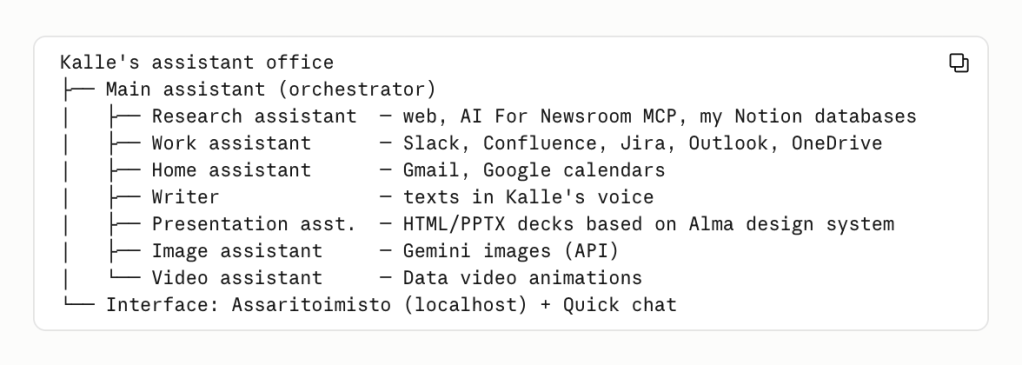
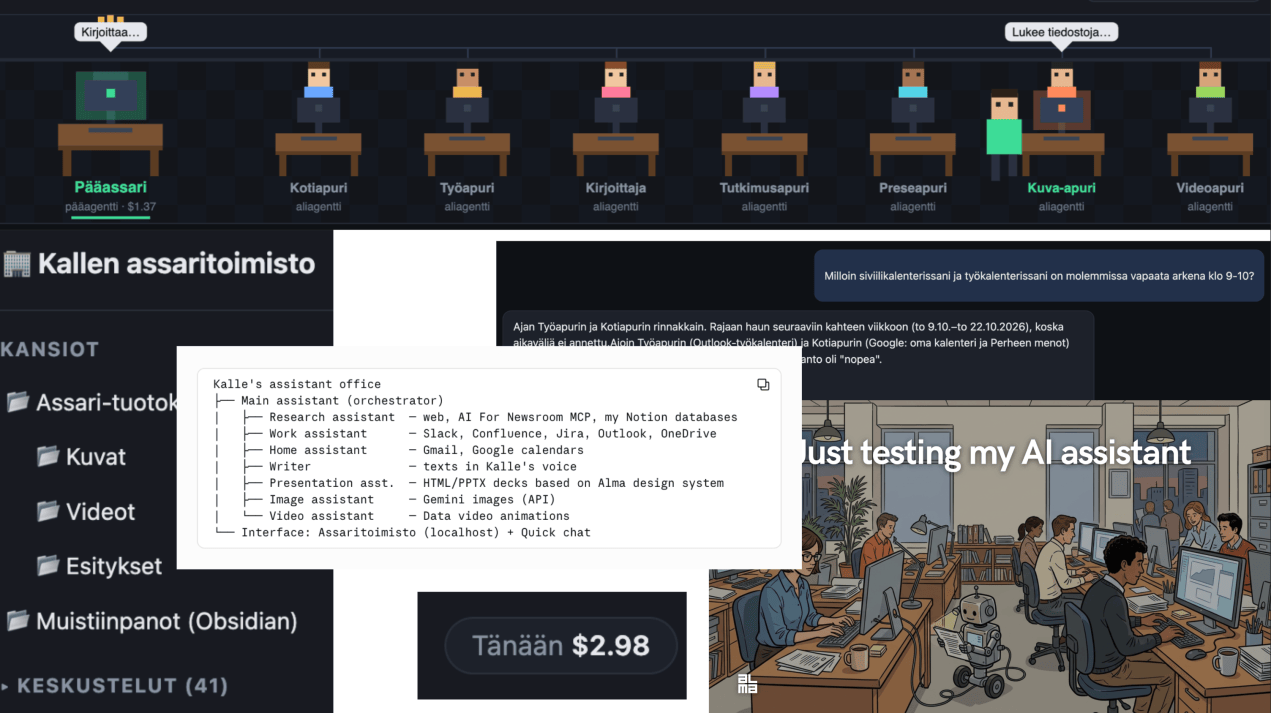
  • Lead assistant (Pääassari). It talks to me, decides whether to delegate, hands out clear assignments, and assembles the results. It’s rulebook is mainly one CLAUDE.md file in my Obsidian vault, plus a general one that applies to all my Claude Code projects on my computer.
  • Seven specialist helpers. Each is one short text file in .claude/agents/, with a job description and a limited set of tools:
    • Research helper (Tutkimusapuri): web search, plus a database of how newsrooms use AI. OSINT: no tools of its own but and the instruction to look tools up from a public directory. This is also connected to my Notion databases where I’ve collected some observations from media industry via a Claude automation.
    • Work helper (Työapuri): connects to my Slack, Confluence, Jira, work email and calendar, Sharepoint.
    • Home helper (Kotiapuri): reads my personal Gmail and family calendars. Read-only but lead assistant writes calendar entries if I confirm.
    • Writer (Kirjoittaja): drafts Linkedin posts and blogs in my voice, using a style guide.
    • Presentation helper (Preseapuri): makes on-brand slide decks (HTML and PowerPoint), based on Alma Media design system.
    • Image and video helpers (Kuva-apuri, Videoapuri): images via Gemini API (a personal one), animated data videos from chart screenshots.
  • The office itself. A browser app where each helper has a pixel-art desk (inspiration for the pixel-art came e.g. from Ippen Media’s Markus Frantz), and the lead assistant walks over to the one it delegates to. Under the hood, a small local Python server runs Claude Code.

The expense tracker: knowing what the office costs
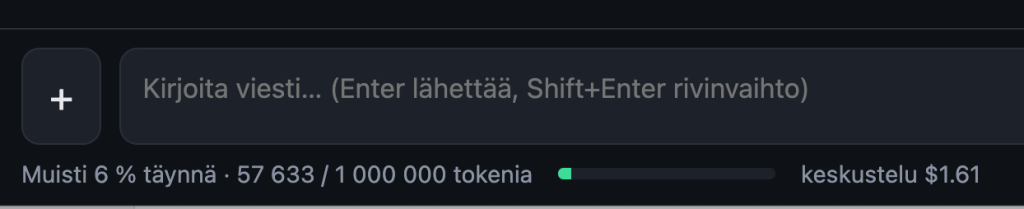
AI helpers cost real money for every run, so I built cost tracking into the office.

  • Every answer is priced. After each run, Claude Code reports the cost in dollars. My office server (palvelin.py) records it with the date and the helper that did the work, and saves it all in a local data.json file.
  • Three views.
    • A ”Today” counter at the top of the office shows total spend for the day.
    • Each helper’s desk shows what that helper has cost today.
    • Each conversation in the sidebar shows its own running cost, and a memory bar shows how full the conversation is.
  • Claude Code’s own status line (~/.claude/statusline.sh) shows the same two numbers in the terminal: the session’s cost and how full the memory is.
  • The tracker changes how I work.
    • The lead assistant sizes up each request (light, medium or heavy) and warns me before heavy runs such as deep research, many images or video rendering. It also offers a cheaper alternative.
    • Long conversations get expensive, because every message rereads the whole history. So the assistant suggests a fresh, short conversation once the memory bar passes 60%.
    • It also led to the cheap ”Pikachat” quick-chat mode, with its own separate cost line.

The rules that make it (at least a bit more) trustworthy

  • Read-only by design. The helpers that touch work and personal data have no write tools at all, so a mistake can’t send an email or edit a Jira ticket. Writing happens only when I explicitly ask, in the main session.
  • Confirm before saving. Nothing goes into the vault, GitHub or Jira without asking me first.
  • Work and personal stay apart. If it’s unclear, the assistant asks ”work or personal?”
  • Cost awareness. See the tracker above. The assistant doesn’t guess dollar amounts. It reads the real figures from get_usage -tool.

Where Obsidian fits

Obsidian is the memory of the office, my ”second brain.” The assistant lives in the vault folder, so everything it learns about me and my writing sits next to my own notes.

  • Two parts. Muistiinpanot/ holds my observations, ideas and learning notes. Blogi-arkisto/ holds about 225 of my published blog posts since 2017, which serve as reference material for my writing voice.
  • The assistant writes, but only with permission. It can write straight into the vault, but it always asks first. At the end of a conversation it asks, ”Should I save a note from this?”
  • Obsidian Sync carries the notes to my other devices automatically.
  • Not for project management. For me, the Obsidian vault is for thinking.

Pros and cons so far

A presentation test based on Alma design system.

Pros

  • I’ve noticed that I want to actually use this regularly and develop it further. Thats a good sign. Sometimes I find using this inside Claude Code as well but its not as fun.
  • Having this as a Chrome tab is a great place for it to be because Chrome is the place I use most (Claude I use in the desktop app).
  • The assistant sees my real notes and blog archive, so it writes, at best, in my voice.
  • Read-only helpers and ask-first rules make delegating to AI feel safer.
  • The cost tracker shows spending per helper and per conversation. This was a good thing to add.
  • Obsidian Sync is good to have.

Cons

  • Obsidian Sync has no API, so Claude’s ”normal” chat and my phone can’t read the vault so far. The workaround like a OneDrive mirror or a private GitHub repo isn’t decided yet.
  • The assistant only works so far in Claude Code, so it is tied to my computer. I would not like to set up a virtual server or buy a second computer just for this.
  • The setup is a bit fiddly.
  • The vault has only about a dozen notes so far, so the ”second brain” payoff depends on me keeping it fed. I am still not very convinced Obsidian is as good as some people say.
Normaali
tekoäly

Näin kasaan tekoälymuistia uuteen työhön mediassa – oppeja ja sudenkuoppia

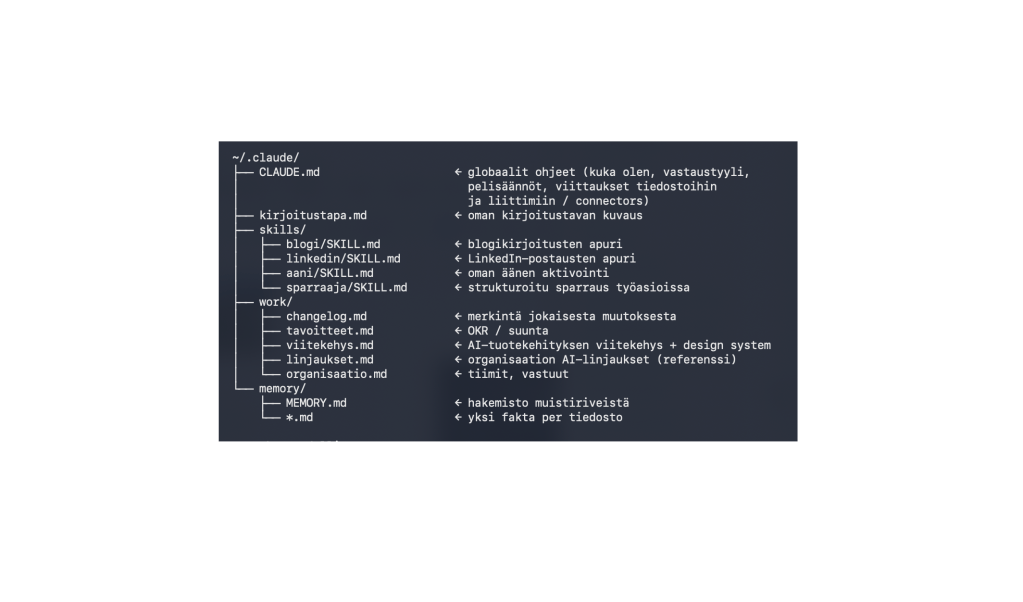
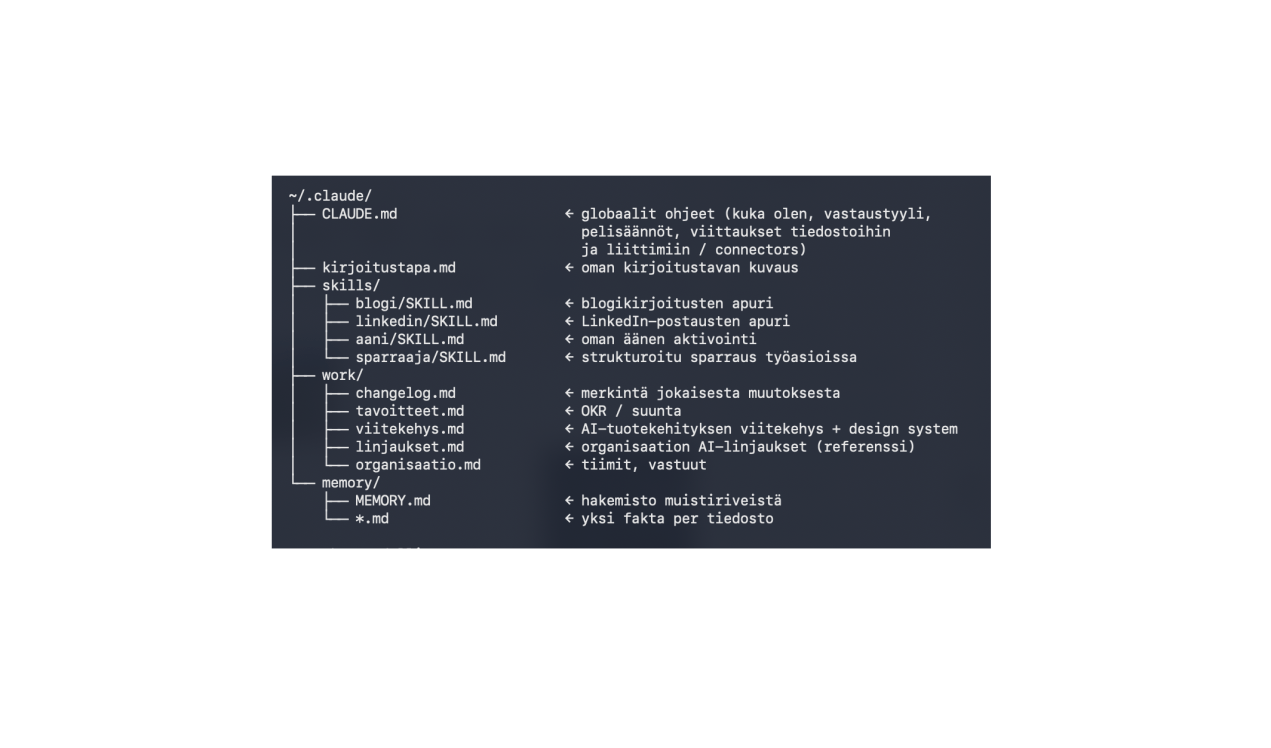
Karkeistettu kuvaus Claude-rakenteestani. Se on yhdistelmä siviili- ja työtarpeita.

Aloitin reilu viikko sitten uudessa työssä toimituksellisen AI-kehityksen parissa. Uudessa työssä on aina paljon tutustuttavaa – ihmisiä, prosesseja, substanssia. Mutta tekoälyaikana on yksi asia, jonka voi tehdä hieman eri tavalla kuin ennen: rakentaa itselle kontekstin eli tavallaan pysyvän asiayhteyden tai työmuistin, joka on automaattisesti saatavilla joka kerta kun avaat uuden keskustelun. Yhteisesti tekoälylle jaetut ohjeet, ovat ne tallessa sitten koodareiden varastointipalvelu Githubissa, omalla koneella tai muualla, tekevät tuloaan myös mediaan. Kirjoitin aiheesta laajemmin aiemmin tässä blogissa.

En ole tässä mikään megaekspertti. Rakennan samalla kun opin, kokeilen, korjaan ja muutan lähestymistapaa sitä mukaa kun ymmärrys kasvaa. Tämä kirjoitus on siis pikemminkin väliraportti kuin ohje kenellekään. Nyt oli tilaisuus aloittaa tämä aiempien puuhastelujen pohjalta puhtaalta pöydältä, koska työn mukana vaihtuu luonnollisesti myös tekoälylle annettava työn konteksti.

Perusongelma on se, että Claude, kuten useimmat tekoälypalvelut, aloittavat jokaisen keskustelun tyhjästä. Vaikka olisit yleisasetuksiin jotain kuvausta itsestäsi ja toimintatavoistasi laittanut, se ei oikeasti kovinkaan hyvin muista, miten missäkin tilanteessa toimit saati mikä asia jäi mihinkin vaiheeseen. Käy työlääksi selittää konteksti aina alusta osittain tai kokonaan.

Itselleni ratkaisuksi rakensin pysyvän ”muistin” tiedostoihin, jotka Claude saa käyttöönsä automaattisesti aina kun avaat uuden keskustelun. Samalla tästä rakentuu minulle päivittyvä tutustumispaketti uuteen työhön.

Käytän Claudea kahdessa eri ympäristössä, joilla on hieman eri käyttötarkoitus: Claude Desktop on päivittäinen työassistentti, käytännössä Macille lataamani sovellus. Claude Code on teknisempi työkalu koodaamiseen ja mm. automatisointiin, jota voi käyttää myös Desktopin kautta, mutta pidän usein enemmän Pääte- eli terminaalikäyttöliittymästä. Muisti täytyy käytännössä rakentaa molempiin erikseen, koska ne yhdistyvät ulkoisiin palveluihin kuten sähköpostiin, kalenteriin, dokumentteihin tai viestintäkanava Slackiin, hieman eri tavoin ja eri laajuudella. Sisältö on kuitenkin pitkälti sama.

Claude Desktop: työasiat samaan projektiin

Claude Desktop on sovelluskäyttöliittymä, jota käytän päivittäiseen työhön: kirjoittamiseen, suunnitteluun, tiedonhakuun. Siellä muisti rakentuu Projects-ominaisuuden varaan. Loin projektin nimeltään Kaikki työasiat, johon liitin keskeisiä työdokumentteja (tavoitteet, linjaukset, organisaatiomalli, yhteisten työtapojen viitekehys) Project Files -osioon. Project Instructions -kentässä on tiivistetty konteksti: kuka olen, miten haluan vastaukset, mistä Claudeen kytketyistä liittimistä se hakee tietoa tarvittaessa (esim. Slack). Tähän projektiin kytketyt keskustelut saavat siis kontekstin automaattisesti, eikä tarvitse selitellä lähtötilannetta joka kerta uudestaan. Olen nähnyt tätä samaa fiksua työtapaa myös ChatGPT:n kanssa varsinkin ihmisillä, jotka eivät halua käyttää komentorivityökaluja. Lisään tänne projektitiedostoihin myös tietyt taidot eli skillit, vaikka voisin sisällyttää ne myös yleisasetuksiin.

Claude Code: sama asia hieman eri tavalla

Claude Code on komentorivityökalu, joka on periaatteessa suunnattu koodaamiseen ja teknisempiin tehtäviin, mutta sillä voi tehdä käytännössä kaikkea. Desktop-sovelluksen erillinen Cowork-ominaisuus – työkalu ei-kehittäjille tiedostojen ja tehtävien automatisointiin – on jäänyt itselläni käyttämättä, koska huomaan tekeväni samat asiat aina Claude Coden puolella. Siellä muisti toimii CLAUDE.md-nimisen tiedoston kautta, jonka työkalu lataa automaattisesti jokaiseen keskusteluun. Käytännössä siellä on sama sisältö kuin Desktop-projektissa.

Clauden yleisrakenteeni on karkeasti kuvattu tämän blogin lähtökuvassa.

Obsidian muistiinpanoja terävöittämään

Obsidian on muistiinpanosovellus, jossa kaikki tieto tallennetaan tavallisina tekstiä sisältävinä markdown-tiedostoina minun tapauksessani omalle koneelle yhteen kansioon. Pidän siellä omia muistiinpanoja, ideoita ja havaintoja, joita en halua jakaa mihinkään järjestelmään. Claude Code pääsee lukemaan tätä Obsidianin kielellä ”holvia” suoraan koneelta, joten muistiinpanot ovat käytettävissä ilman että niitä tarvitsee kopioida minnekään.

Obsidian ei välttämättä kaikessa työssä tuo kauheasti lisäarvoa, mutta siitä on siviili-Claudessani ollut sen verran apua kokonaisuuksien välisten yhteyksien hahmottamisessa, että olen pitänyt sen käytössä.

Siviilipuolella Obsidian-tiedot päivittyvät automaattisesti Drive-kansiooni. Tällä tavoin voin pyytää halutessani Claudea lisäämään sinne tietoja myös tien päällä ollessani, Clauden kännykkäsovelluksellani.

Työpäiväkirja M365:ssä

Pidän Word-muotoista työpäiväkirjaa Microsoftin pilvipalvelussa (SharePoint), johon pääpiirteissään kirjaan päivän tapahtumat ja ajatukset. Claude Desktop osaa hakea sen suoraan Microsoft 365 -liittimen kautta halutessani. Sama onnistuu Claude Codessa. Käytännössä siis työdokumentit antavat pysyvän kontekstin ja työpäiväkirja tuo mukaan sen mitä on tapahtunut tänään tai tällä viikolla.

Nähtäväksi jää, miten pieteetillä jaksan päivittää työpäiväkirjaa, mutta ainakin alkuvaiheessa aion näin tehdä, ihan oman ajattelunikin jäsentämiseksi.

Päivityslogiikka kuntoon

Claude on ohjeistettu muistuttamaan, jos se keskustelussamme havaitsee tiedon, joka vaikuttaa vanhentuneen. Desktop ja Code voivat lukea samoja tiedostoja, joten päivitys riittää tehdä kerran kunhan huolehtii, että molemmat on ohjattu samaan lähteeseen. Automaattista synkronointia näiden kahden välillä ei ole.

Mitä enemmän tekoälyä käytetään tiimeissä ja organisaatioissa, sitä tärkeämmäksi nousee se, että yhteisesti jaetut dokumentit ovat kunnossa, olivat ne sitten suunnitteludokumentteja, prosessikuvauksia tai muuta.

Tämä sanottua, erilaisista syistä johtuen näiden ohjeiden ajan tasalla pitäminen ei aina ole ihan helppo homma. Usein esimerkiksi tietoturvasyistä on fiksua antaa joillekin liittimille vain lukuoikeus eikä kirjoitusoikeutta, mikä toisaalta voi hidastaa tekemistä, kun et voi sanoa vaikkapa Claudelle suoraan, että lisää sinne-ja-sinne sitä-ja-sitä.

Yksi asia on ollut selvästi ongelma, tai ainakin sekoittanut omaa päätäni. Minulla on erikseen työ-Claude ja siviili-Claude. Siviilipuolella ei ole työasioita, se on selkeä raja, mutta osin nämä menevät ristiin. Toisaalta oma Claudeni on kytketty omaan Driveeni ja omaan Slack-työympäristööni, joihin en työ-Claudea haluaisikaan kytkeä. Jää nähtäväksi, miten näiden kahden Clauden rinnakkaiselo tulee toimimaan. Toistaiseksi ratkaisuna on ollut pitää siviili-Claude joskus auki työkoneen ”kakkosselaimella”, jos sitä satun tarvitsemaan. Samassa Desktop-sovelluksessa ei voi olla kahta profiilia auki yhtä aikaa.

Viikon kokeilujen perusteella tämä rakenne toimii ehkä paremmin kuin odotin sekä Desktopissa että Codessa, mutta se vaatii kurinalaisuutta eli osa tiedoista pitää ajan tasalla itse ja lisätä uutta sitä mukaa kun sitä tulee. Se toki hieman auttaa, jos ohjeistat Claudea muistuttamaan tästä asiasta soveltuvissa kohdissa.

Normaali
Strategia ja liiketoiminta, tekoäly

Vibekoodaus journalismissa on nyt kuuminta hottia – tätä se tarkoittaa & uhat ja mahdollisuudet

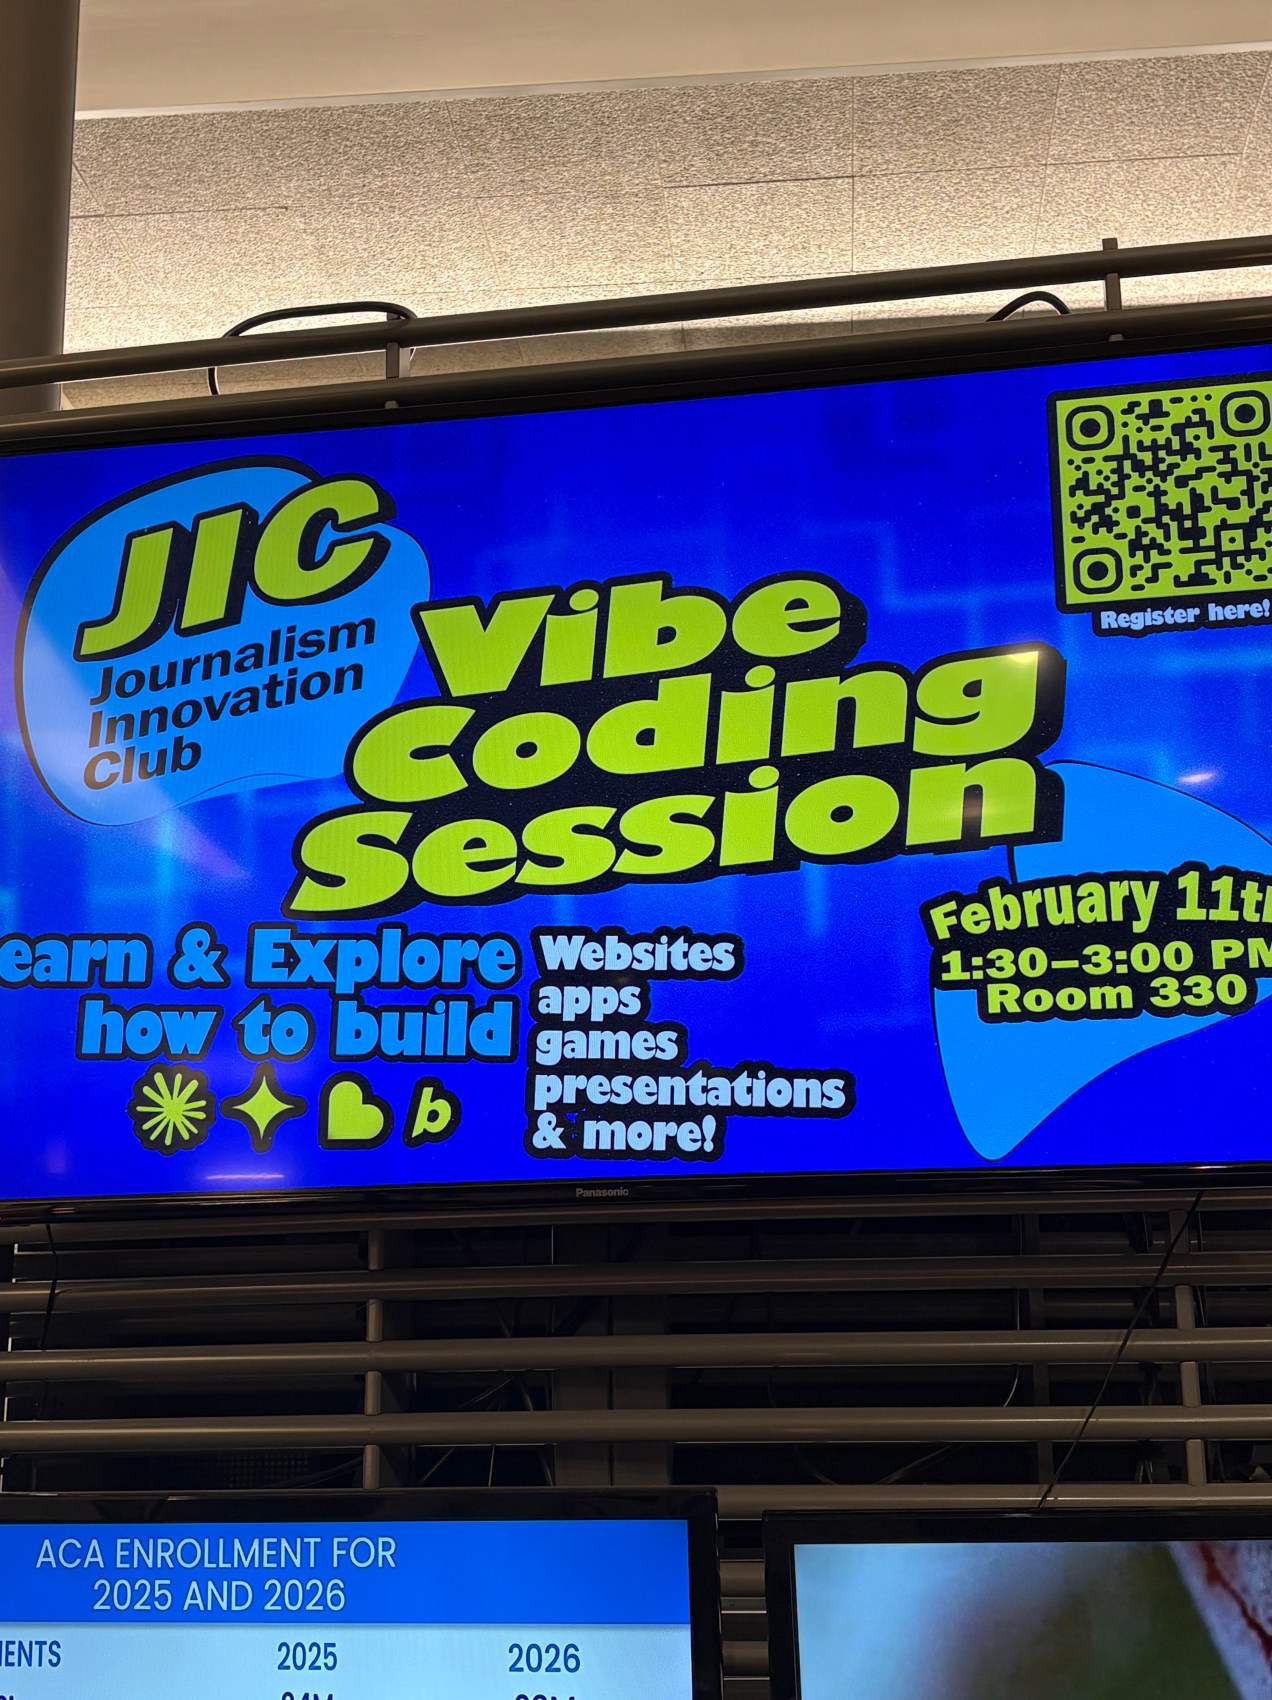
Tämä journalistista vibekoodauskerhoa mainostava kuva on otettu helmikuussa City University of New Yorkin Craig Newmark Graduate School of Journalismin tiloissa.

Vibekoodaus tai fiiliskoodaus tarkoittaa ohjelmointia ilman syvää teknistä ymmärrystä – mennään ”fiiliksen mukaan” siten, että esimerkiksi sovellusta rakennetaan kuvailemalla haluttuja toimintoja luonnollisella kielellä. Kyse ei kuitenkaan ole vain teknisestä ilmiöstä, vaan voidaan ajatella, että esimerkiksi uutismedioissa se avaa mahdollisuuksia laajempaan työtapojen ja työkulttuurin muutokseen. Koetan tässä kirjoituksessa avata, miten.

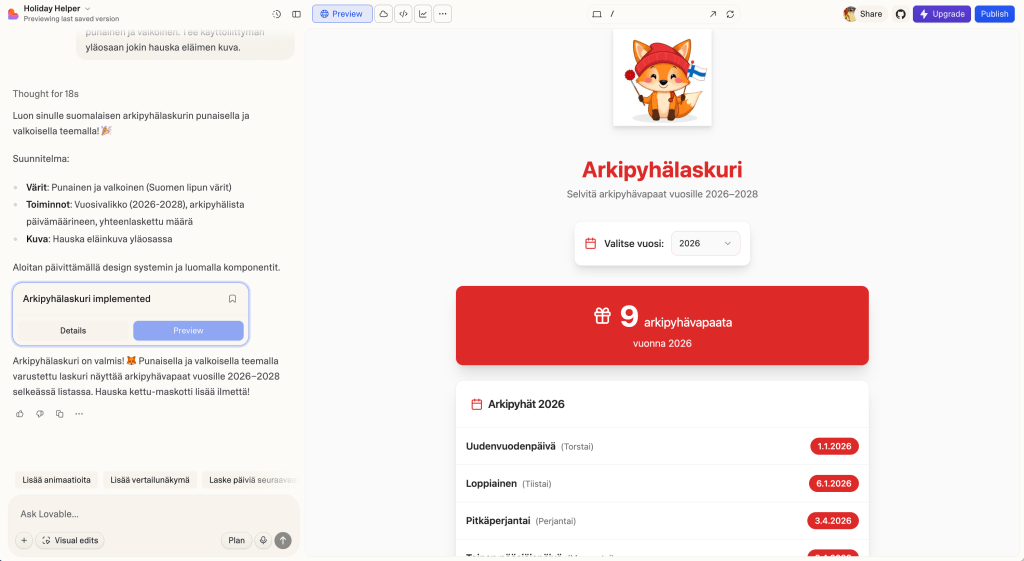
Tapoja fiiliskoodaukseen on monia, niin kuin on palveluitakin. Tunnetuimmasta päästä suuren yleisön silmissä lienee ruotsalainen kasvuraketti Lovable. Sillä voit halutessasi pyöräyttää vaikkapa arkipyhävapaalaskurin ja jakaa sen kaverille:

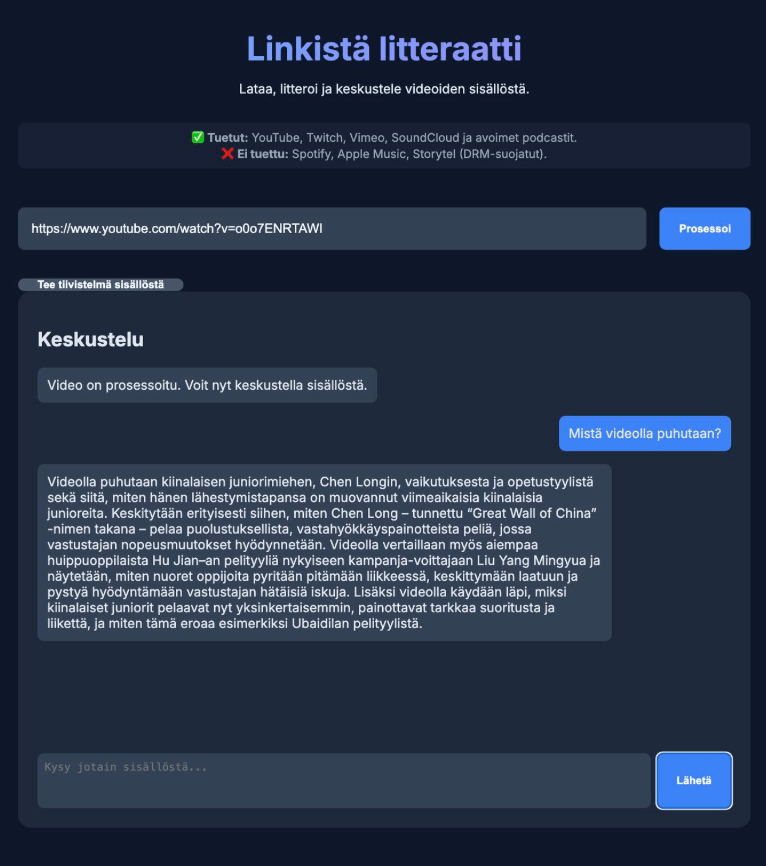
Luonnollisella kielellä tähän tapaan toimivia työkaluja ovat myös esimerkiksi ChatGPT Codex, Cursor, Claude Code tai Replit. Itse käytän eniten Codexia sekä Googlen Antigravityä, jolle annetaan hallitusti pääsy koneesi tiedostoihin, jolloin ohjelmia voi rakentaa helposti myös lokaalisti eli omalle koneelle sen sijaan että ne sijaitsevat pilvessä kuten Lovablen tapauksessa. Lokaaliuden etuna on esimerkiksi se, että omalle koneelle ladatun avoimen lähdekoodin kielimallin käyttö ei maksa mitään. Tällä logiikalla voi rakentaa vaikkapa Youtube-videoiden litteroijan, joka toimii näin:

  • Syötä linkki esim. Youtube-videoon tai podcastiin.
  • Sisältö latautuu omalle koneelle automaattisesti yleensä audiona.
  • Ääni muuttuu transkriptioksi ja latautuu txt-tiedostona omaan kansioonsa.
  • Kielimalli antaa käyttäjän kysymyksiin vastauksia transkription pohjalta.

Runko on tehty Python-ohjelmointikielellä, lataus hoituu yt-dlp:llä (avoimen lähdekoodin komentorivityökalu), litterointi OpenAI:n puheentunnistusmalli Whisperillä ja kielimallin käyttö avoimen lähdekoodin ohjelmiston Ollaman kautta. Käyttöliittymä on selaimessa.

Tämä sanottua, on hyvä tiedostaa, että tällaisissa on aina vaarana ns. demoefekti: wau, vaikuttaapa näppärältä, tuotannollistetaan tämä. Siinä on sitten kuitenkin aina edessä mm. panos–tuotos-arvio. Joka sisältää esimerkiksi sen, paljonko työkalun käyttö ja ylläpito maksaisi ihan oikeasti. Tässä piileekin ”vibekoodaussuuntauksen” suurin pullonkaula organisaatioissa: syntyy valtava määrä ideoita ja prototyyppejä – joista osa varmasti erittäin hyviä – joiden putki tuotantoon on kuitenkin joko erittäin hidas tai kokonaan tukossa. Yksi oppi tässä on minusta se, että varo hurmaantumasta liian hienoista demoesityksistä. Demo on ihan eri asia kuin tuotantoon viety versio.

Omalta osaltani haluan korostaa, että en osaa koodata, enkä ole koskaan pitänyt itseäni erityisen teknisenä ihmisenä. Jos minäkin pystyn tähän, pystyt sinäkin! Siinä sivussa opit koodista itse asiassa aika paljon, vaikka et koodaamaan varsinaisesti opikaan.

Jos aloitat aivan nollasta, suosittelen menemään osoitteeseen lovable.dev, kirjautumaan sinne Googlen tunnuksilla (pari klikkausta), jolloin käytössäsi on pieni määrä krediittejä, joilla voit kokeilla tehdä asioita ilmaiseksi.

Mahdollisuudet: nopeus, ketteryys ja uudenlaiset tavat tehdä töitä

Vibekoodaus madaltaa siis kynnystä rakentaa omia työkaluja. Kun idean ja prototyypin väliin ei tarvita raskasta kehitysprosessia, toimittaja voi esimerkiksi:

  • Tehdä datan puhdistus- ja analyysityökaluja omaan käyttöönsä
  • Automatisoida rutiineja (litterointi, tiedonhaku, aineiston luokittelu)

Kun kaikki ei ole enää riippuvaista keskitetystä kehitystiimistä tai keskitetystä budjetista, se voi tehdä toimituksesta ketterämmän.

Uhat: demoefekti, tekninen velka ja hallitsematon työkaluräjähdys

Demoefekti on mielestäni suurimpia uhkia, kuten aiemmin jo lyhyesti kuvasin. Prototyyppi näyttää toimivalta, mutta:

  • Kuka ylläpitää sitä?
  • Kuka vastaa tietoturvasta?
  • Mitä tapahtuu, kun API-hinnat (API = rajapinta) muuttuvat?
  • Entä jos palvelu katoaa?

Toimituksissa voi syntyä kymmeniä pieniä työkaluja, joilla ei ole omistajaa eli tahoa, joka oikeasti katsoisi työkalun perään. Tämä on omiaan synnyttämään teknistä velkaa.

Koska vibekoodaus tuntuu “ilmaiselta”, kustannuksia ei aina nähdä: kun volyymi kasvaa, kasvavat myös kulut. Jos toimitus rakentaa työkaluja vibekoodaamalla, pullonkauloiksi voivat myös muodostua ainakin seuraavat asiat:

  • Ymmärtääkö tekijä, miten malli tekee päätelmiä?
  • Miten varmistetaan datan käsittelyn eettisyys?
  • Dokumentoidaanko työkalun toimintalogiikka?

Erityisen herkkä kysymys on lähdesuoja. Jos toimittaja syöttää arkaluonteista materiaalia pilvipalveluun, se on erityisen iso riski.

  • Minne data tallentuu?
  • Käytetäänkö sitä mallien koulutukseen?
  • Täyttääkö ratkaisu organisaation tietoturvavaatimukset?

Lokaalit eli omalla koneella toimivat ratkaisut voivat olla turvallisempia, mutta nekin vaativat ymmärrystä riskeistä.

Parhaimmillaan vibekoodaus voi siis demokratisoida kehittämistä, nopeuttaa innovointia ja tehdä ainakin osasta toimittajia nykyistä enemmän palveluiden rakentajia. Toisaalta vibekoodaus voi johtaa hallitsemattomaan työkalujen sillisalaattiin, josta ei ole kokonaiskäsitystä kenelläkään. Tämän myötä vastuut hämärtyvät ja voi myös syntyä kitkaa sisältöpuolen ja kehityspuolen välille. Yksi ydinkysymys on, mikä on se prosessi, jolla parhaat ideat suppiloidaan tuotantoon. Jos tämä ei toimi, syntyy helposti tyytymättömyyttä.

Haluaisin itse ajatella jotenkin niin, että ajatuksena ei todellakaan ole, että kaikista tulee koodareita, vaan siitä, että jonkintasoisesta ohjelmoinnista tulee yksi uusi taito kirjoittamisen rinnalle. Yksi konkreettinen käyttötapa on ihan vain sekin, että teet ajattelemastasi konseptista prototyypin, jonka näytät sitten haluamillesi sidosryhmille. Näin nämä saavat hyvän käsityksen siitä, mitä ajat takaa.

Lähteitä, joita olen hyödyntänyt tässä kirjoituksessa:

Vibe coding for newsroom projects (Innovation.dw 15.12.2025)

Vibe coding is turning reporters into builders, and that’s a good thing for media (Fast Company 12.1.2026)

Rise of the vibecoding journalists (Nieman Lab joulukuu 2025)

Normaali